MQ502.COM
 林夕设计家园
常用
搜索
社区
图片
生活
站内
百度
Bing
Google
Perplexity
Bing
百度
Google
Perplexity
YOU
360
搜狗
神马
Hugging Face
GitHub
飞桨
魔搭
和鲸
掘金
知乎
文心一格
花瓣AI圈
Civitai
OpenArt
NightCafe
DeviantArt
Lexica
淘宝
京东
下厨房
香哈菜谱
12306
快递100
去哪儿
124
1
C-Eval
一个全面的中文基础模型评估套件
标签:
反馈
相关摘要:一个全面的中文基础模型评估套件
C-Eval是什么
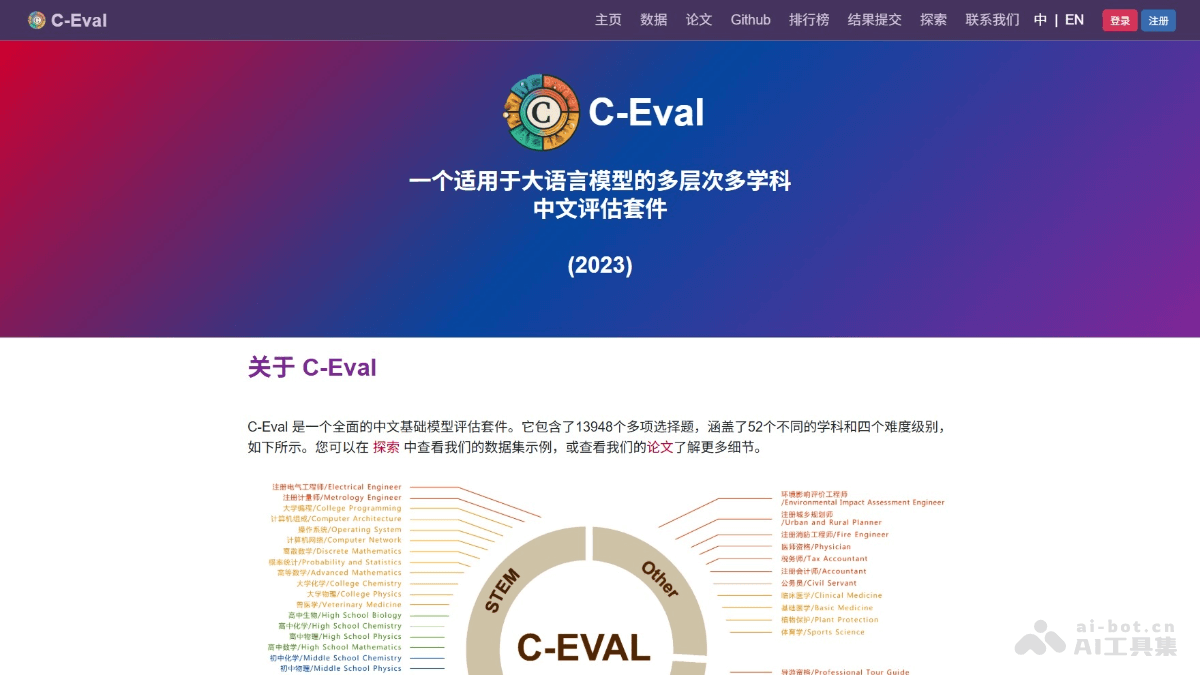
C-Eval是适用于大语言模型的多层次多学科中文评估套件,由上海交通大学、清华大学和爱丁堡大学研究人员在2023年5月份联合推出,包含13948个多项选择题,涵盖52个不同的学科和四个难度级别,用在评测大模型中文理解能力。通过零样本(zero-shot)和少样本(few-shot)测试,C-Eval 能评估模型在未见过的任务上的适应性和泛化能力。
C-Eval的主要功能
- 多学科覆盖:C-Eval 包含 52 个不同学科的题目,涵盖 STEM、社会科学、人文科学等多个领域,全面评估语言模型的知识储备。
- 多层次难度分级:设有四个难度级别,从基础到高级,细致评估模型在不同难度下的推理和泛化能力。
- 量化评估与标准化测试:包含 13948 个多项选择题,通过标准化评分系统提供量化性能指标,支持不同模型的横向对比。
如何使用C-Eval
-
数据下载:
-
Hugging Face 下载:
-
from datasets import load_dataset
dataset = load_dataset("ceval/ceval-exam", name="computer_network")-
- 或者直接下载 ZIP 文件并解压:
wget https://huggingface.co/datasets/ceval/ceval-exam/resolve/main/ceval-exam.zip
unzip ceval-exam.zip- 选择评估模式
-
零样本(Zero-shot):模型在没有任何示例的情况下直接回答问题。
-
少样本(Few-shot):模型在少量示例(如 5 个)的提示下回答问题。
-
- 准备模型:确保模型已经加载并准备好进行推理。如果是基于 Hugging Face 的模型,用以下代码加载:
from transformers import AutoModelForCausalLM, AutoTokenizer

model_name = "your-model-name"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)- 构建提示(Prompt)
- 零样本提示:
以下是中国关于{科目}考试的单项选择题,请选出其中的正确答案。
{测试题目}
A. {选项A}
B. {选项B}
C. {选项C}
D. {选项D}
答案:-
- 少样本提示:
以下是中国关于{科目}考试的单项选择题,请选出其中的正确答案。
{题目1}
A. {选项A}
B. {选项B}
C. {选项C}
D. {选项D}
答案:A
[k-shot 示例]
{测试题目}
A. {选项A}
B. {选项B}
C. {选项C}
D. {选项D}
答案:- 生成回答:使用模型生成回答。提取生成文本中的答案选项(A、B、C、D),或者计算每个选项的概率并选择最高概率的答案。
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(**inputs)
response = tokenizer.decode(outputs[0], skip_special_tokens=True)
answer = extract_answer(response) # 自定义函数,提取答案选项- 评估模型
-
对于验证集(
val),直接计算准确率。 - 对于测试集(
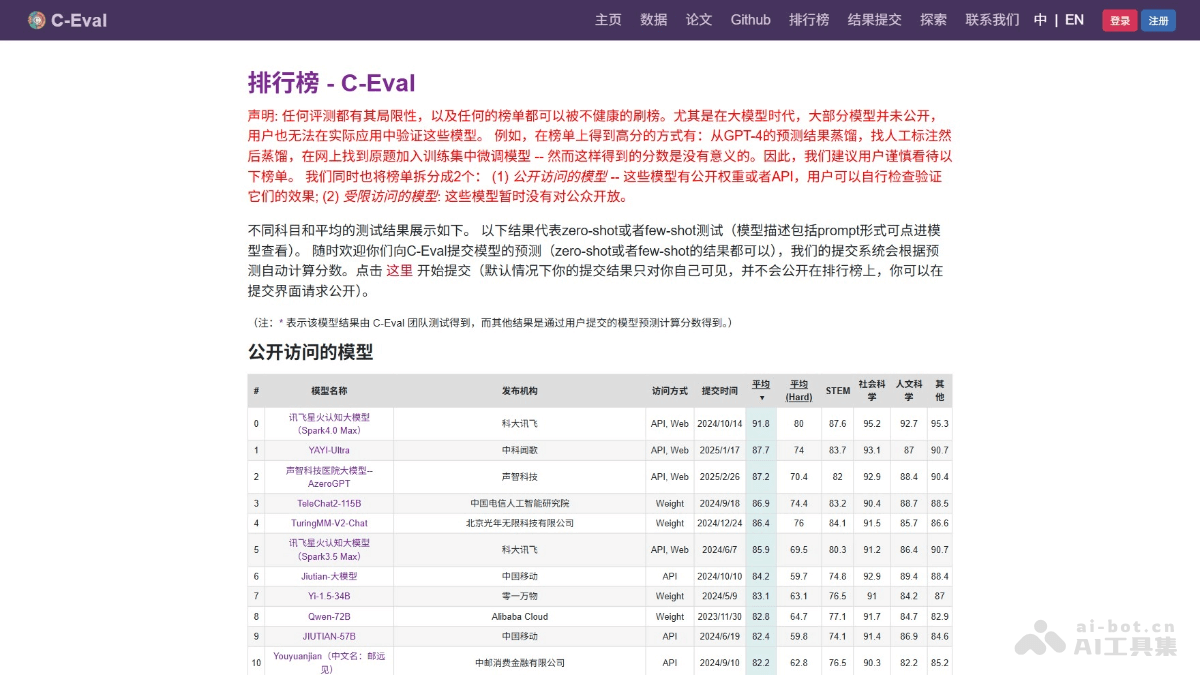
test),需要将结果提交到 C-Eval 官方平台获取评分。
-
from sklearn.metrics import accuracy_score

# 假设 `predictions` 是模型的预测结果,`labels` 是真实答案
accuracy = accuracy_score(labels, predictions)
print(f"Validation Accuracy: {accuracy:.2f}")- 提交结果:准备 JSON 文件,包含所有测试题目的预测结果:
{
  "chinese_language_and_literature": {
    "0": "A",
    "1": "B",
    ...
  },
  ...
}-
-
登录 C-Eval 官方平台并提交结果以获取最终评分。
-
C-Eval的应用场景
- 语言模型性能评估:全面衡量语言模型的知识水平和推理能力,帮助开发者优化模型性能。
- 学术研究与模型比较:为研究人员提供标准化的测试平台,分析和比较不同语言模型在各学科的表现,推动学术研究和技术进步。
- 教育领域应用开发:助力开发智能辅导系统和教育评估工具,用模型生成练习题、自动评分,提升教育领域的智能化水平。
- 行业应用优化:在金融、医疗、客服等行业,评估和优化语言模型的领域知识和应用能力,提升行业智能化解决方案的效果。
- 社区合作与技术评测:作为开放平台,促进开发者社区的交流与合作,为模型竞赛和技术评测提供公平的基准测试工具。