AI-BOT.CN
AI工具集
常用
搜索
社区
图片
生活
站内
百度
Bing
Google
Perplexity
Bing
百度
Google
Perplexity
YOU
360
搜狗
神马
Hugging Face
GitHub
飞桨
魔搭
和鲸
掘金
知乎
文心一格
花瓣AI圈
Civitai
OpenArt
NightCafe
DeviantArt
Lexica
淘宝
京东
下厨房
香哈菜谱
12306
快递100
去哪儿
开源CMS怎么选:先看内容模型,再看生态
选CMS时容易被功能列表带偏。本文建议先明确内容模型与发布流程,再评估插件生态与长期维护成本,并给出三类站点的匹配建议。
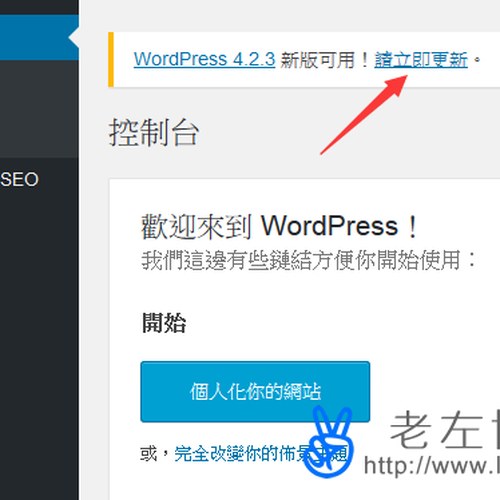
WordPress接入AI爬虫配置指南:先从能抓取再把内容讲清楚
越来越多用户通过AI搜索找答案,WordPress站点需要重新检查可抓取性。本文梳理GEO配置的四个动作:放开AI爬虫、修好索引设置、统一结构化数据、把关键信息写成可读文本。
Crawlsure插件发布:WordPress技术SEO开始“边说人话边修问题”
新发布的WordPress插件Crawlsure把技术SEO检查与AI搜索适配做进后台,强调用直白语言解释问题并支持一键修复。本文分析它的能力范围,以及这类工具的真实价值。
网站改版不改URL:迁移期的重定向策略该怎么定
改版最容易踩的坑是URL变化导致流量断崖。本文给出迁移期的重定向策略:哪些必须一条对一条、哪些可以批量规则、以及上线后如何监控流失。
内链不是随便加几个链接:三种有效结构与两种无效做法
内链决定权重如何流动、用户如何浏览。本文给出三种有效的内链结构,并点出两种看似勤奋实则无效的做法,附一份可执行的检查清单。
WordPress核心要内置MCP?这轮AI集成的方向变了
近期WordPress生态讨论把MCP协议引入核心,插件也开始支持AI客户端直连站点。本文解释MCP是什么、对站长意味着什么,以及接入前必须想清楚的权限问题。
结构化数据别乱堆:三类标记最值得先做
结构化数据能帮助搜索理解页面,但堆得越多不等于效果越好。本文指出最值得优先实现的三类标记,以及多个插件同时输出标记时如何避免冲突。
llms.txt到底要不要做?先看清它对搜索没有直接作用
llms.txt被不少文章称为AI时代的必备文件,但Google已明确表示搜索不使用它。本文梳理这个文件的真实用途、适用场景,以及它不该取代的三件基础工作。
2026年Core Web Vitals怎么优化:三个指标对应三类改法
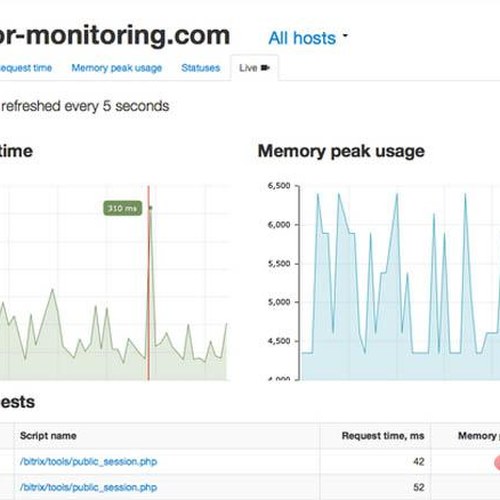
页面体验仍是排名因素之一,2026年关注点集中在LCP、INP与CLS。本文按指标拆解优化动作,并给出一个可执行的排查顺序,避免盲目上插件。
TTFB降不下来?先分清是主机、数据库还是CDN的问题
首字节时间是后端性能的综合体现。本文给出一条排查路径:从DNS与连接、到主机与数据库、再到CDN与缓存,帮你在半小时内定位瓶颈在哪一层。
图片优化四步走:WebP、尺寸、懒加载与首屏例外
图片往往是页面体积的最大来源。本文给出四步优化法:转格式、定尺寸、加懒加载、首屏例外处理,并说明每步对加载指标的实际影响。
内容集群怎么做才有用:从关键词堆叠转向主题权威
内容集群被视为提升主题权威的核心方法,但多数站点做成了关键词堆叠。本文给出集群的三层结构设计方法,以及内链与更新维护的具体做法。
AEO选型对比:不同CMS对AI搜索的支持差在哪
面向AI搜索优化(AEO)时,不同CMS的能力差异明显。本文按托管建站、WordPress、无头CMS三类对比它们在爬虫控制、结构化数据与纯文本输出上的支持情况。
外贸站被挂马一次的代价:网站安全该做哪些基础动作
外贸独立站是植入暗链与挂马的高发目标,一次事故可能导致浏览器风险提示与客户流失。本文列出六项基础安全动作,按投入产出排序,适合中小团队直接执行。
外贸WordPress站流量上不去,多半卡在这三个技术细节
外贸独立站常见问题是建好半年没流量。本文从页面加载、内容更新与安全维护三个维度,复盘一个真实场景的排查路径,给出可复用的优化清单。
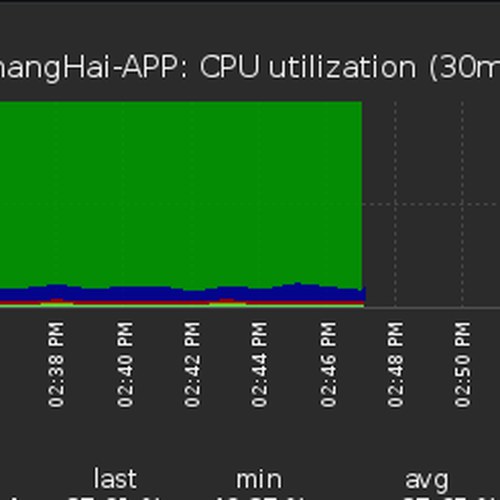
告别Kafka中转:实时数据分析链路可以更短
为做实时分析而引入消息队列,是很多团队的默认选择,但链路越长延迟越高。本文讨论在什么情况下可以省掉中转层,以及简化后需要补上的能力。
Uber把服务网格依赖关系分析自动化,微服务治理省了哪些事
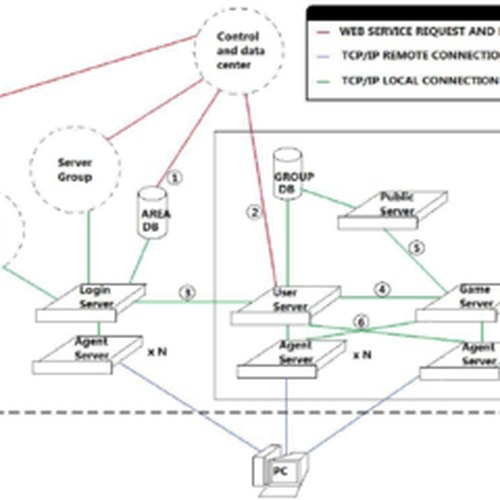
Uber实现了服务网格依赖关系的自动化分析,减少人工梳理服务调用链的成本。本文拆解这类方案的实现思路,以及对中大型团队的借鉴意义。
一张详情页同时适配手机折叠屏平板,多端自适应怎么做
折叠屏与平板让“一套布局打天下”越来越难。本文以详情页为例,讲清断点设计、栅格与内容优先级的处理方式,给出一套可落地的多端适配思路。
Zod突然“会编译”了:校验库提速9倍背后的取舍
TypeScript校验库Zod引入编译式校验,官方称速度提升约9倍、内存占用大幅下降。本文解释这种做法的原理、代价,以及项目是否值得跟进。
追踪数据也能脱敏:Grafana Tempo 3.1的几个实用更新
Grafana Tempo 3.1新增基于查询的追踪数据脱敏与采样机制支持。本文说明这两项能力解决什么问题,以及接入时对存储与查询性能的影响。