MQ502.COM
 林夕设计家园
常用
搜索
社区
图片
生活
站内
百度
Bing
Google
Perplexity
Bing
百度
Google
Perplexity
YOU
360
搜狗
神马
Hugging Face
GitHub
飞桨
魔搭
和鲸
掘金
知乎
文心一格
花瓣AI圈
Civitai
OpenArt
NightCafe
DeviantArt
Lexica
淘宝
京东
下厨房
香哈菜谱
12306
快递100
去哪儿
124
1
CMMLU
一个综合性的大模型中文评估基准
标签:
反馈
相关摘要:一个综合性的大模型中文评估基准
CMMLU是什么
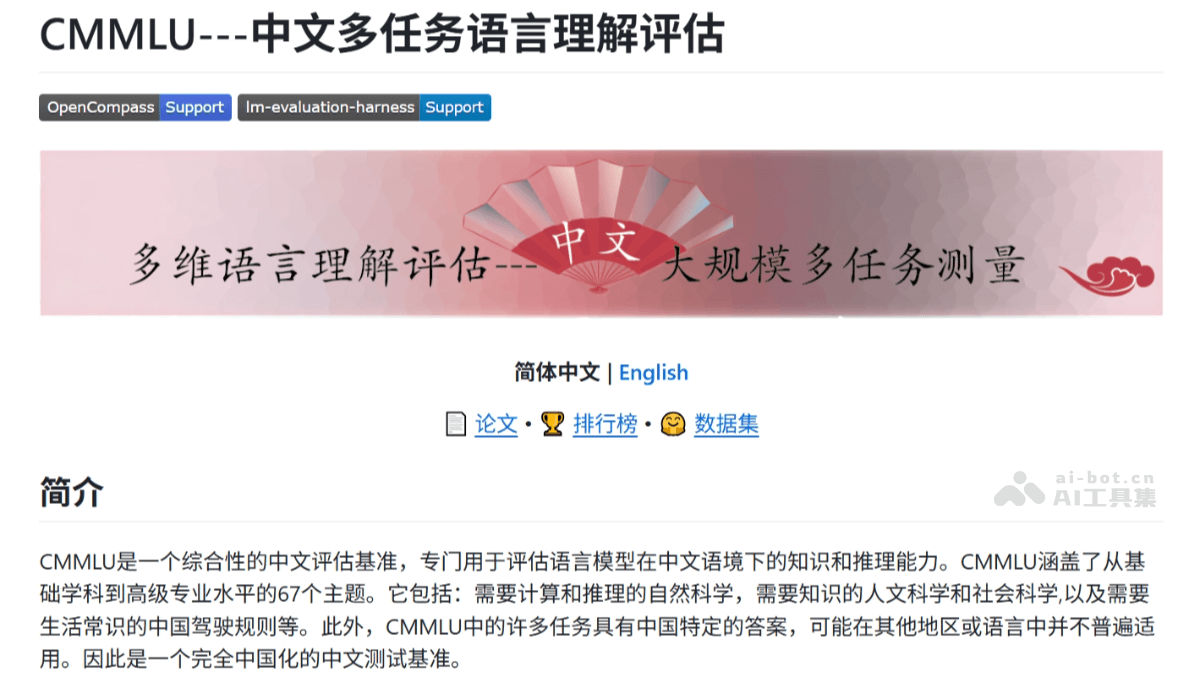
CMMLU是综合性的中文评估基准,专门用在评估语言模型在中文语境下的知识和推理能力,涵盖从基础学科到高级专业水平的67个主题。包括需要计算和推理的自然科学,需要知识的人文科学和社会科学,及需要生活常识的中国驾驶规则等。CMMLU中的许多任务具有中国特定的答案,可能在其他地区或语言中并不普遍适用。CMMLU提供丰富的测试数据和排行榜,支持多种评估方式,如five-shot和zero-shot测试,是衡量中文语言模型性能的重要工具。
CMMLU的主要功能
- 排行榜:展示不同语言模型在five-shot和zero-shot测试下的表现,帮助比较模型性能。
- 数据集:提供开发和测试数据,支持快速使用和评估。
- 预处理代码:提供提示生成方法,方便模型训练和测试。
- 评估工具:支持多种评估方式,便于研究者和开发者测试模型能力。
如何使用CMMLU
- 获取数据集:
-
从GitHub下载:访问 CMMLU GitHub页面:https://github.com/haonan-li/CMMLU/,在
data目录中找到开发和测试数据集。 -
通过Hugging Face获取:访问Hugging Face平台:https://huggingface.co/datasets/haonan-li/cmmlu,直接加载CMMLU数据集。
-
- 准备测试环境:
-
安装依赖:确保安装了必要的Python库,如
transformers、datasets等。 - 克隆代码库:克隆CMMLU的GitHub仓库,获取测试代码和预处理工具。
-
git clone https://github.com/haonan-li/CMMLU.git
cd CMMLU- 预处理数据:在
src/mp_utils目录中,使用提供的脚本对数据进行预处理,生成适合模型输入的格式。
python src/mp_utils/preprocess.py- 运行评估代码
-
选择模型:根据需要评估的语言模型,加载模型和tokenizer。
- 运行测试脚本:在
script目录中,运行测试脚本,评估模型在不同任务上的表现。
-
python script/evaluate.py --model <model_name> --data_path <data_path>- 提交测试结果:
-
开源模型:直接提交拉取请求(PR),更新测试代码和结果。
-
未开放模型:将测试代码和结果发送到指定邮箱(如
haonan.li@librai.tech),等待验证后更新到排行榜。
-
- 分析结果:在GitHub页面的排行榜部分,查看模型在不同任务上的表现,分析模型的优缺点。
CMMLU的应用场景
- 语言模型性能评估:用在测试和比较语言模型在中文多任务场景下的知识和推理能力,帮助优化模型架构。
- 教育领域的智能辅导:开发智能辅导系统,为学生提供多学科的练习和学习建议,提升学习效果。
- 智能客服优化:评估模型在特定领域的知识理解能力,优化智能客服系统,提高客户服务质量。
- 文化知识传播:用CMMLU的数据集开发文化问答系统,传播中国文化知识,促进文化传承。
- 医疗健康知识评估:评估语言模型在医学领域的知识理解能力,辅助开发医疗咨询工具,提供健康建议。