MQ502.COM
 林夕设计家园
常用
搜索
社区
图片
生活
站内
百度
Bing
Google
Perplexity
Bing
百度
Google
Perplexity
YOU
360
搜狗
神马
Hugging Face
GitHub
飞桨
魔搭
和鲸
掘金
知乎
文心一格
花瓣AI圈
Civitai
OpenArt
NightCafe
DeviantArt
Lexica
淘宝
京东
下厨房
香哈菜谱
12306
快递100
去哪儿
124
1
Jev
TypeSafe AI 推出的 AI 结构化决策模型
标签:
反馈
相关摘要:TypeSafe AI 推出的 AI 结构化决策模型
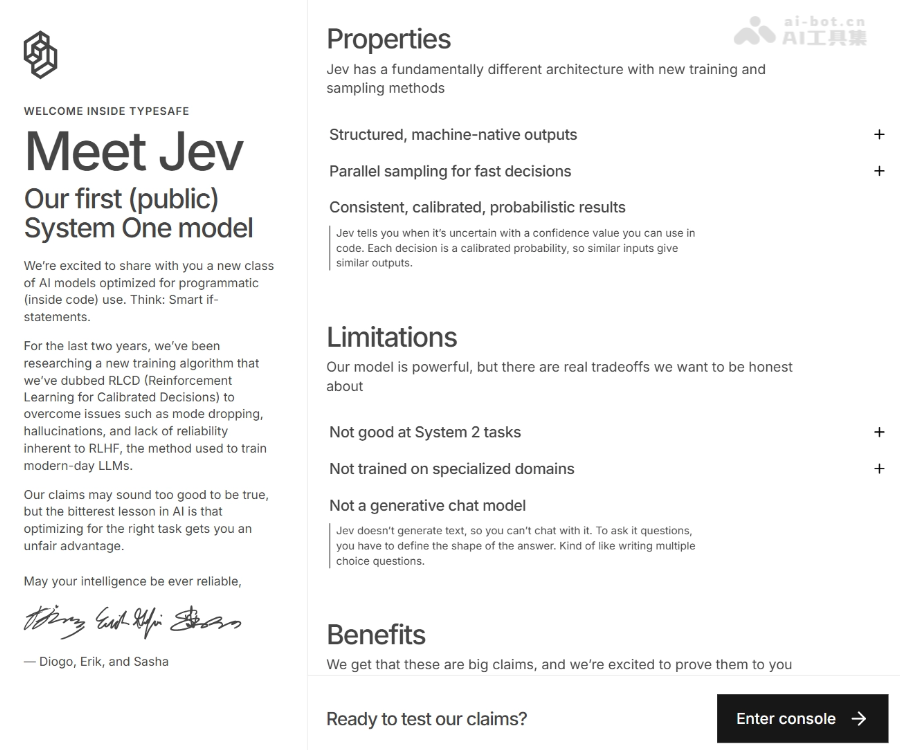
Jev是什么
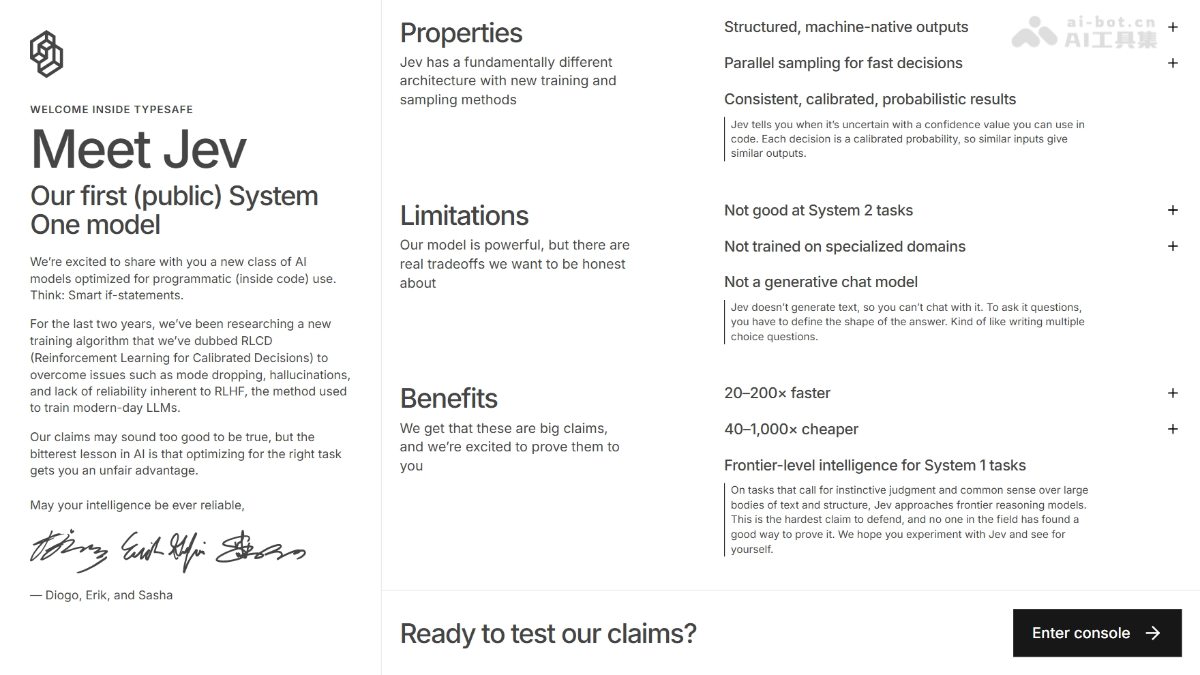
Jev 是 TypeSafe AI 推出的 AI 结构化决策模型,创始人是前 OpenAI 研究员 Diogo Almeida。Jev基于 Transformer 但不是大语言模型,不会输出句子,而是在预设选项内返回类型化决策:Choice(选项)、Score(评分)、Noul(概率),附带置信度。模型响应延迟约 70—500 毫秒,专用于 Agent 高频判断场景,如工具路由、工单分流、游戏决策。
Jev的主要功能
- Choice 选项决策:从预设的选项列表(最多 255 个)中选出最合适的一项,返回选项、概率分布和置信度,适用于路由和分类。
- Score 评分:将输入按自定义量表(如 1–5 级)打分,返回分数、概率和置信度,用于衡量紧迫度、质量或风险等级。
- Noul 是非判断:对”这条陈述是否为真”输出一个 0–1 的概率值,适用于是否需要转人工、是否需采取行动等二元判断。
- 并行多问题:一次 API 调用可同时混问多个问题,共享同一份输入、独立并行评估,加问题几乎不增加延迟也不产生上下文腐化。
- 置信度输出:Choice 和 Score 附带校准后的置信度评分,代码可据此做分流——高置信自动执行、低置信升级大模型或转人工。
- 无幻觉类型化输出:严格限定在用户预设的选项和类型范围内返回,无需 JSON 解析,杜绝格式错误和越界乱答。
- 极低延迟:端到端响应约 70–500 毫秒,比同类大语言模型快 20–200 倍,支持每秒约 10 次的高频决策循环。
Jev 的三种输出形态
- Choice(选项决策):从用户预先定义的选项列表中(最多 255 个)选出最合适的一项,返回所选选项、各选项的概率分布以及置信度,适用于路由、分类、工具选择等”多选一”场景。
- Score(量表评分):将输入状态按用户划定的评分量表打分,返回分数、各级别概率分布和置信度,适用于紧迫度评估、质量评级、风险分级等”打几分”场景。
- Noul(是非判断):对一条陈述是否为真输出一个 0–1 之间的概率值,不单独返回置信度,适用”是否需要转人工””是否要求采取行动”等二元判断场景。
三者关系:可在同一次 API 调用中任意混用,共享同一份输入状态、并行独立评估——加问题几乎不增加延迟,也不会产生上下文腐化。
如何使用Jev
- 注册账号:访问Jev官网 https://console.typesafe.ai/ ,注册可直接使用。
- 获取 API Key:在控制台创建并复制 API Key,用于后续的接口调用鉴权。
- 准备输入状态(State):把当前局面整理成结构化的文本或数据,如游戏状态、网页元素清单、邮件内容等,Jev 看的是状态描述而非原始画面。
- 定义问题(Questions):根据需求选用三种原语——Choice(选项决策)、Score(量表评分)、Noul(是非判断),每个问题只问一件具体的事。
- 发送请求调用:通过 REST API 或官方 SDK 发送请求,State 和多个问题放在同一次调用中,模型会并行评估所有问题。
- 解析类型化结果:直接拿到选项/分数/概率及置信度等强类型结果,无需写 JSON 提示词或额外解析器,代码可直接消费。
- 用代码组合多问题:把复杂判断拆成多个原子问题后,用代码逻辑加权组合各维度结果,而非让模型在一次提问内权衡。
- 接入置信度分流:根据返回的置信度设计策略,如高于 90% 自动执行、60–90% 升级调用大模型、低于 60% 转人工。
- 用自有数据校准验证:上线自动决策规则前,先用业务数据检验模型概率与实际结果是否相符,不能只看单次置信度数值。
- 与生成模型搭配使用:需要产出文字的场景(如填写表单内容)另行调用生成模型,Jev 专职负责”选哪个”的高频判断环节。
Jev的核心优势
- 极致速度:端到端延迟仅 70–500 毫秒,比同类大语言模型快 20–200 倍,支持每秒约 10 次高频决策循环。
- 无格式幻觉:输出严格限定在用户预设的选项和类型范围内,无需 JSON 解析,杜绝乱答和格式错误。
- 校准置信度:返回经过校准的概率分布和置信度评分,代码可据此做自动执行、模型升级或人工介入的分流决策。
- 并行多问题:一次调用可同时评估多个独立问题,共享同一份输入且几乎不增加延迟、不产生上下文腐化。
- 决策与生成解耦:把”判断”从完整文本生成中剥离出来,避免为大模型杀鸡用牛刀,让生成模型专注其擅长的文字产出。
- 代码可组合:原子化问题设计让业务逻辑沉淀在代码中,优先级变化只需改系数而非重写 prompt,可控性和可维护性更强。
- 语义理解通用:基于 Transformer 架构,具备通用语义理解能力,规则和候选频繁变化时无需像传统分类器那样重新训练。
Jev的同类竞品对比
| 对比维度 | Jev(System One 决策模型) | Gemini 2.5 Flash(通用 LLM 做分类判断) |
|---|---|---|
| 模型本质 | 专为决策训练的分类模型,无文本生成能力 | 通用自回归多模态大模型,文本生成是主业 |
| 响应延迟 | 70–500 毫秒,稳定可预期 | 数百毫秒至数秒,受 prompt 长度和输出 token 影响大 |
| 调用成本 | 输入 0.042 美元/百万 Token,输出免费 | 输入输出双向计费,综合成本高 10–20 倍 |
| 分类准确率 | 社区实测商业邮件分类中略低于 Gemini | 通用任务上准确率更高,语义理解更全面 |
| 输出形态 | 类型化决策+概率分布+校准置信度 | 自由文本或约束 JSON,无原生校准置信度 |
| 幻觉控制 | 严格限定预设选项,无格式幻觉 | 存在越界输出、字段漂移的可能 |
| 多任务并行 | 一次调用并行评估多个独立问题,零额外延迟 | 需串行多次调用或拼装复杂 prompt,易上下文腐化 |
| 多模态能力 | 仅处理结构化文本状态 | 原生支持图文音视频,可直接”看图判断” |
Jev的应用场景
-
Agent 路由与工具调度:高频判断当前意图该调用搜索、数据库还是代码执行,只从预设的有效 API 列表中选择,消除幻觉工具名的同时用毫秒级响应支撑 Agent 的快速循环。
-
客服工单分流:一次调用并行判断工单的归属团队、紧急程度和信息是否齐全,让每天百万级的邮件/工单以近乎零成本完成自动分诊。
-
游戏与模拟决策:接收游戏引擎输出的结构化状态,在预设动作集内以每秒约 10 次的速度高频选招,驱动 DOOM、Mario 等游戏的 AI 玩家。
-
浏览器自动化:将页面元素编号后由 Jev 逐步决定点击哪个按钮、填写哪个输入框,仅在需要产出文字时才转调生成模型,实现查机票等任务十几步操作仅数秒完成。
-
上下文压缩与模型路由:在百万级 Token 的长上下文中判断哪些信息关键、哪些可丢弃,并实时预测任务复杂度以决定派给轻量模型还是旗舰模型,实现成本与效果的最优分配。